Wir haben die fünf häufigsten EF-Core-Fehler gemessen: was jeder wirklich kostet
N+1, ganze Entitäten, Tracking, Abfragen in Schleifen und Filtern im Speicher: jeder EF-Core-10-Fehler gegen die Lösung gemessen. Bis zu 9× langsamer.
Vlado Pandžić · Gründer · Senior .NET-Architekt
Veröffentlicht · 8 Min. Lesezeit
Inhalt
- Wie wir gemessen haben
- Die Ergebnisse
- 1. Filtern nach ToList(): 9× langsamer, 700× so viel Speicher
- 2. Ganze Entitäten für eine Liste: 2,4× langsamer, 12× so viel Speicher
- 3. N+1: hier 1,9× langsamer, über ein Netzwerk viel schlimmer
- 4. Eine Abfrage in einer Schleife: 1,8× langsamer, und dasselbe Netzwerkproblem
- 5. Tracking für eine Liste, die niemand ändert: 1,5× langsamer
- Warum die Zahlen eine Untergrenze sind
- Wie Sie sie in Ihrer Anwendung finden
- Fragen, die wir oft hören
- Wie wir arbeiten
Jeder .NET-Entwickler kennt die Ratschläge: N+1 vermeiden, AsNoTracking verwenden, keine ganzen Entitäten laden. Was meistens fehlt, ist die Zahl. Wie viel langsamer ist der Fehler wirklich? Genug, dass es zählt, oder etwas, das man irgendwann einmal behebt?
Also haben wir gemessen. Fünf Fehler, die wir in EF-Core-Anwendungen immer wieder sehen, jeweils neben ihrer Lösung, auf denselben Daten und mit dem Standardwerkzeug für Benchmarks.
Die kurze Antwort: Der schlimmste, das Filtern nach ToList(), war 9-mal langsamer und brauchte 700-mal so viel Speicher. Der harmloseste, Tracking für eine reine Leseliste, kostete immer noch 46 % mehr Zeit. Und die beiden Fehler, die am unschuldigsten aussehen, N+1 und Abfragen in einer Schleife, werden auf einem echten Datenbankserver deutlich schlimmer, als unsere Zahlen zeigen.
Wie wir gemessen haben
- EF Core 10 auf .NET 10, mit SQLite als Datenbankdatei auf der Festplatte.
- Die Daten: 1.000 Kunden, 10.000 Bestellungen mit einem 2 KB großen Notizfeld und 50.000 Bestellpositionen. Ein Viertel der Bestellungen ist offen.
- Das Werkzeug: BenchmarkDotNet 0.15.8, mit 3 Aufwärm- und 12 Messiterationen pro Fall, inklusive Aufzeichnung der Speicherallokationen.
- Jeder Fall öffnet einen neuen
DbContext, wie es ein Web-Request tun würde. - Die Maschine: ein Laptop mit Intel Core Ultra 7 255H.
Eine wichtige Einschränkung: SQLite läuft im Prozess der Anwendung, jede Abfrage ist also ein Funktionsaufruf und kein Weg über das Netzwerk. Auf SQL Server oder Azure SQL kostet jede zusätzliche Abfrage auch einen Netzwerk-Roundtrip. Darauf kommen wir weiter unten zurück, denn es verändert das Bild für zwei der fünf Fehler.
Die Ergebnisse
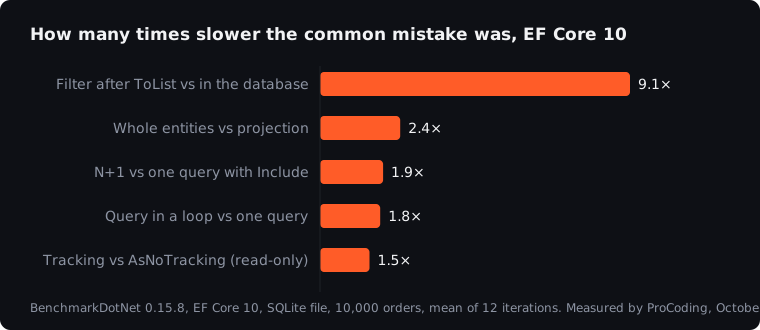
| Fehler | Zeit | Die Lösung | Zeit | Langsamer | Speicher |
|---|---|---|---|---|---|
Filtern nach ToList(), im Speicher |
91,4 ms | Filtern in der Datenbank | 10,0 ms | 9,1× | 43,6 MB gegenüber 0,06 MB |
| Ganze Entitäten für eine Liste | 22,5 ms | Projektion auf die benötigten Spalten | 9,6 ms | 2,4× | 12,7 MB gegenüber 1,0 MB |
| N+1: Positionen pro Bestellung geladen | 3,5 ms | Eine Abfrage mit Include |
1,9 ms | 1,9× | 1,8 MB gegenüber 0,8 MB |
| Eine Abfrage pro Kunde in einer Schleife | 19,3 ms | Eine Abfrage für alle Kunden | 10,9 ms | 1,8× | 2,6 MB gegenüber 0,3 MB |
| Reine Leseliste mit Tracking | 27,1 ms | AsNoTracking |
18,6 ms | 1,5× | 13,3 MB gegenüber 10,9 MB |
Jetzt der Reihe nach, jeweils mit dem Code.
1. Filtern nach ToList(): 9× langsamer, 700× so viel Speicher
Der Klassiker: ein ToList() an der falschen Stelle, und der Filter läuft in C# statt in SQL.
var open = db.Orders.ToList()
    .Where(o => o.Status == "Open" && o.Total > 500)
    .Count();
Die Datenbank schickt alle 10.000 Bestellungen samt ihren 2 KB großen Notizen, und die Anwendung wirft die meisten davon weg. Die Lösung überlässt die Arbeit der Datenbank:
var open = db.Orders.Count(o => o.Status == "Open" && o.Total > 500);Der Fehler allokierte für einen einzigen Aufruf 43,6 MB, die Lösung 62 KB. Auf einem Webserver bedeutet dieser Unterschied, dass der Garbage Collector unter jedem Request hart arbeitet, und er wächst mit der Tabelle. Meistens schleicht er sich über eine Methode ein, die List<T> oder IEnumerable<T> statt IQueryable<T> zurückgibt, sodass der Filter erst angehängt wird, wenn die Daten schon da sind.
2. Ganze Entitäten für eine Liste: 2,4× langsamer, 12× so viel Speicher
Eine Listenansicht braucht vier Spalten. Der Code lädt vollständige Entitäten, einschließlich eines großen Textfelds, das niemand anzeigt:
var rows = db.Orders.AsNoTracking()
    .Include(o => o.Customer)
    .Where(o => o.Status == "Open")
    .ToList()
    .Select(o => new OrderRow(o.Id, o.Customer.Name, o.Date, o.Total));
Eine Projektion fragt die Datenbank nur nach dem, was die Ansicht braucht:
var rows = db.Orders
    .Where(o => o.Status == "Open")
    .Select(o => new OrderRow(o.Id, o.Customer.Name, o.Date, o.Total))
    .ToList();
Aus 12,7 MB wurde 1 MB. Je breiter die Tabelle, und jede Tabelle wird über die Jahre breiter, desto größer der Abstand. Projektionen werden außerdem nie getrackt und bekommen den Vorteil aus dem letzten Punkt damit gratis dazu.
3. N+1: hier 1,9× langsamer, über ein Netzwerk viel schlimmer
Eine Abfrage für die Bestellungen, dann eine weitere für die Positionen jeder einzelnen Bestellung:
var orders = db.Orders.OrderBy(o => o.Id).Take(100).ToList();
foreach (var order in orders)
    total += db.OrderLines.Count(l => l.OrderId == order.Id);
Das sind 101 Abfragen. Mit Include ist es eine:
var orders = db.Orders.OrderBy(o => o.Id).Take(100)
    .Include(o => o.Lines)
    .ToList();
In unserem Test betrug der Unterschied 1,6 ms. Das klingt harmlos, aber SQLite hatte kein Netzwerk. Auf einem SQL Server im selben Rechenzentrum dauert ein Roundtrip typischerweise irgendwo zwischen einer halben und ein paar Millisekunden. Hundert zusätzliche Roundtrips bringen dann jeder Seite, die das tut, ungefähr 50 bis 200 ms mehr, und die Seite mit heute 100 Zeilen hat im nächsten Jahr 1.000.
4. Eine Abfrage in einer Schleife: 1,8× langsamer, und dasselbe Netzwerkproblem
Dasselbe Muster in anderer Form: eine Schleife über die Kunden, eine Abfrage pro Kunde.
foreach (var id in customerIds)
    count += db.Orders.Count(o => o.CustomerId == id && o.Status == "Open");
Eine einzige Abfrage erledigt dieselbe Aufgabe:
var count = db.Orders.Count(o => customerIds.Contains(o.CustomerId) && o.Status == "Open");Lokal kosteten 200 Abfragen gegenüber einer 1,8× so viel Zeit und 7,7× so viel Speicher. Über ein Netzwerk addieren die 200 Roundtrips dieselben 0,1 bis 0,4 Sekunden wie bei N+1. Solche Schleifen verstecken sich in Importen, Hintergrundjobs und Berichten, und deshalb wachsen nächtliche Läufe von Minuten auf Stunden.
5. Tracking für eine Liste, die niemand ändert: 1,5× langsamer
Standardmäßig hält EF Core von jeder geladenen Entität eine Kopie vor, um Änderungen zu erkennen. Für eine Ansicht, die Daten nur anzeigt, ist das verschwendete Arbeit:
var orders = db.Orders.Where(o => o.Status == "Open").ToList();var orders = db.Orders.AsNoTracking().Where(o => o.Status == "Open").ToList();46 % langsamer und 2,4 MB mehr Speicher, bei jedem Laden einer Liste. Das ist der harmloseste der fünf Fehler und am leichtesten zu beheben: ein Aufruf, oder QueryTrackingBehavior.NoTracking als Standard für einen reinen Lesekontext.
Warum die Zahlen eine Untergrenze sind
Zwei der fünf Fehler, N+1 und Abfragen in einer Schleife, drehen sich vor allem um die Anzahl der Roundtrips. Unser Aufbau hat das Netzwerk komplett ausgeklammert und zeigt deshalb nur die Kosten innerhalb der Anwendung. Eine grobe Orientierung für einen echten Server:
| Zusätzliche Abfragen pro Seite | Bei 0,5 ms pro Roundtrip | Bei 2 ms pro Roundtrip |
|---|---|---|
| 10 | +5 ms | +20 ms |
| 100 | +50 ms | +200 ms |
| 1.000 | +0,5 s | +2 s |
Die anderen drei Fehler, Filtern im Speicher, ganze Entitäten und Tracking, betreffen die Menge der Daten, die unterwegs ist, und den Speicher, den sie belegt. Auch sie werden durch ein Netzwerk schlimmer, denn jedes unnötige Megabyte muss hindurch.
Wie Sie sie in Ihrer Anwendung finden
- Sehen Sie sich das SQL an. Aktivieren Sie in der Entwicklung das EF-Core-Logging mit
LogTo(Console.WriteLine)oder rufen SieToQueryString()auf einer Abfrage auf, und zählen Sie die Abfragen pro Seite. - Suchen Sie nach
ToList()undAsEnumerable(), gefolgt vonWhere,CountoderFirst, und nach Repository-Methoden, dieList<T>zurückgeben. - Suchen Sie nach Schleifen, die eine Abfrage enthalten, auch nach den versteckten in lazy geladenen Navigationseigenschaften.
- Messen Sie die langsamsten Ansichten vor und nach einer Korrektur, so wie wir es hier getan haben. Entscheidend ist die Korrektur, die die Zahl bewegt.
Die vollständige Liste der Ursachen, einschließlich derer, die wir hier nicht gemessen haben, etwa fehlende Indizes und Paginierung, die immer langsamer wird, finden Sie in unserem Artikel darüber, warum EF Core langsam ist.
Fragen, die wir oft hören
Ist EF Core selbst langsam?
Nach unserer Erfahrung nicht. In allen fünf Fällen war die Lösung immer noch EF Core, nur anders eingesetzt. Die meisten langsamen EF-Core-Anwendungen sind langsam wegen der Art, wie die Abfragen geschrieben sind, nicht wegen der Bibliothek.
Sollten wir stattdessen Dapper oder reines SQL verwenden?
Für eine Handvoll sehr heißer Abfragen kann das sinnvoll sein. Für den Rest bringen die obigen Korrekturen den Großteil des Gewinns, und Sie behalten einen einheitlichen Weg für den Datenzugriff. Die Datenschicht neu zu schreiben, ist selten der erste Schritt.
Gelten diese Ergebnisse auch auf SQL Server?
Die Richtung gilt, und bei N+1 und Schleifen werden die Abstände wegen des Netzwerks noch größer. Die genauen Millisekunden hängen von Ihrem Server, Ihren Daten und Ihren Indizes ab. Deshalb lohnt es sich, die eigenen langsamsten Ansichten zu messen.
Wir sind noch auf EF6. Gilt das auch für uns?
Dieselben Fehler gibt es auch in EF6, und die Korrekturen sind ähnlich. Der Umstieg auf EF Core ist ein eigenes Projekt, das wir in unserem Artikel zur Migration von EF6 zu EF Core behandeln.
Für Anwendungen, die noch auf EF6 laufen, haben wir dieselben Abfragen auf EF6 und EF Core 10 nebeneinander gemessen: EF6 vs EF Core 10.
Wie wir arbeiten
Genau das ist unsere Arbeit. ProCoding ist ein .NET-Studio in Split, Kroatien, und die Performance von EF Core ist ein Bereich, in dem wir viel Zeit verbringen: die Abfragen finden, die am meisten kosten, sie mit Messungen vorher und nachher beheben und dafür sorgen, dass die Datenschicht mit den wachsenden Daten Schritt hält. Eigenständig, mit Ihrem Team oder als freiberuflicher .NET-Entwickler in Ihrem Team. Der erste Schritt ist ein kostenloses 30-minütiges Gespräch.
Quellen
- BenchmarkDotNet, das Benchmark-Werkzeug, das wir verwendet haben
- Efficient querying, Microsoft Learn
- Tracking vs. no-tracking queries, Microsoft Learn
- Simple logging in EF Core, Microsoft Learn
- Eigene Messungen, Oktober 2026, wie oben beschrieben
Dieser Artikel dient nur der allgemeinen Information und ist keine Rechts-, Steuer-, Finanz- oder sonstige Fachberatung. Szenarien, Beispiele und Berechnungen dienen der Veranschaulichung. Nutzungsbedingungen und Haftungsausschluss.